分类: 分类2

  • 家庭急救包配置清单:从创可贴到AED的完整方案

    家庭急救包配置清单:从创可贴到AED的完整方案

    意外从不预约。当家人突发割伤、烫伤、过敏反应,或者更严重的状况时,一个准备充分的家庭急救包可能就是生死之间的关键缓冲。

    基础版急救包(必备)

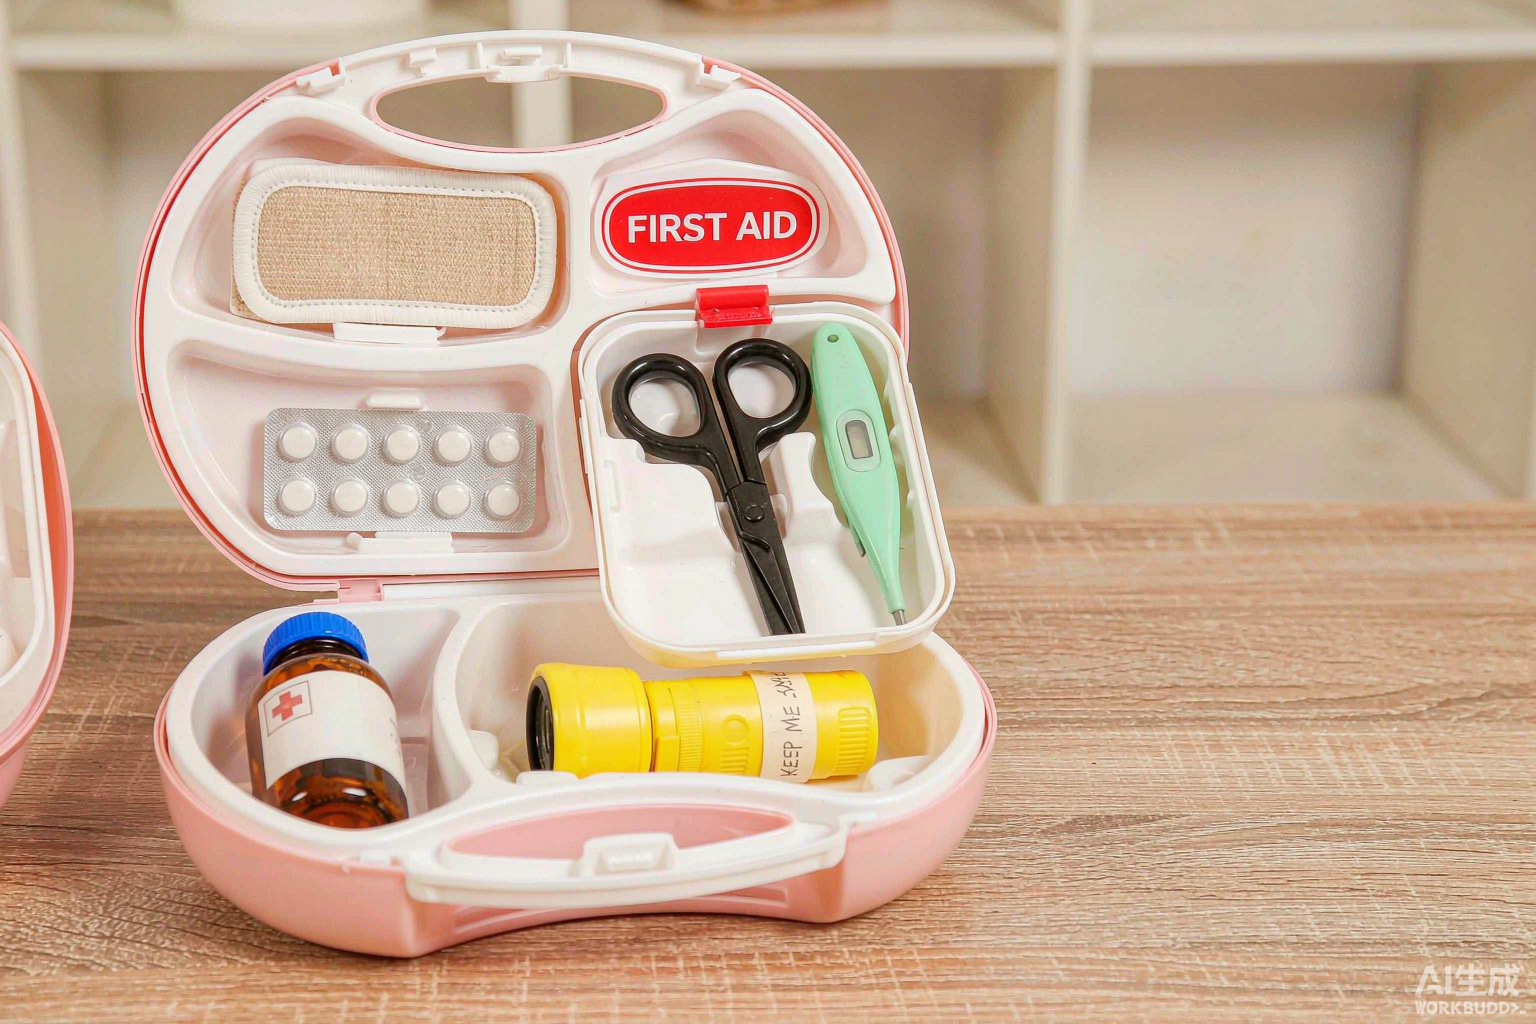
    每个家庭都应准备一个基础急救包,包含以下核心物品:

    • 创伤处理:不同尺寸的创可贴、无菌纱布、医用胶带、弹性绷带、止血带
    • 消毒用品:碘伏棉签、酒精棉片、生理盐水
    • 工具类:医用剪刀、镊子、体温计、一次性手套
    • 药品类:退烧药、止泻药、抗过敏药、烫伤膏

    进阶版配置

    有老人、儿童或慢性病患者的家庭,建议增加以下配置:

    • 血压计和血糖仪:用于日常监测和紧急情况下的基础判断
    • 雾化器:应对哮喘等呼吸系统急症
    • 急救毯:轻便保温,失温急救必备
    • 口服补液盐:腹泻脱水时快速补充电解质

    AED:从公共到家庭

    自动体外除颤器(AED)曾经是公共场所的专属设备,如今已有适合家庭使用的便携式型号。心脏骤停后的「黄金四分钟」内使用AED,存活率可提高数倍。对于有心脏病史的家庭,AED值得认真考虑。

    维护与更新

    急救包不是「配置一次就万事大吉」。建议每半年检查一次:药品是否过期、耗材是否受潮、电池是否有电。把急救包放在所有家庭成员都知道且容易取用的位置。

    急救知识比急救物品更重要。建议家庭成员一起学习基础急救技能,让物品真正发挥作用。

  • 旧衣改造时尚:把过季衣服变成当季单品

    旧衣改造时尚:把过季衣服变成当季单品

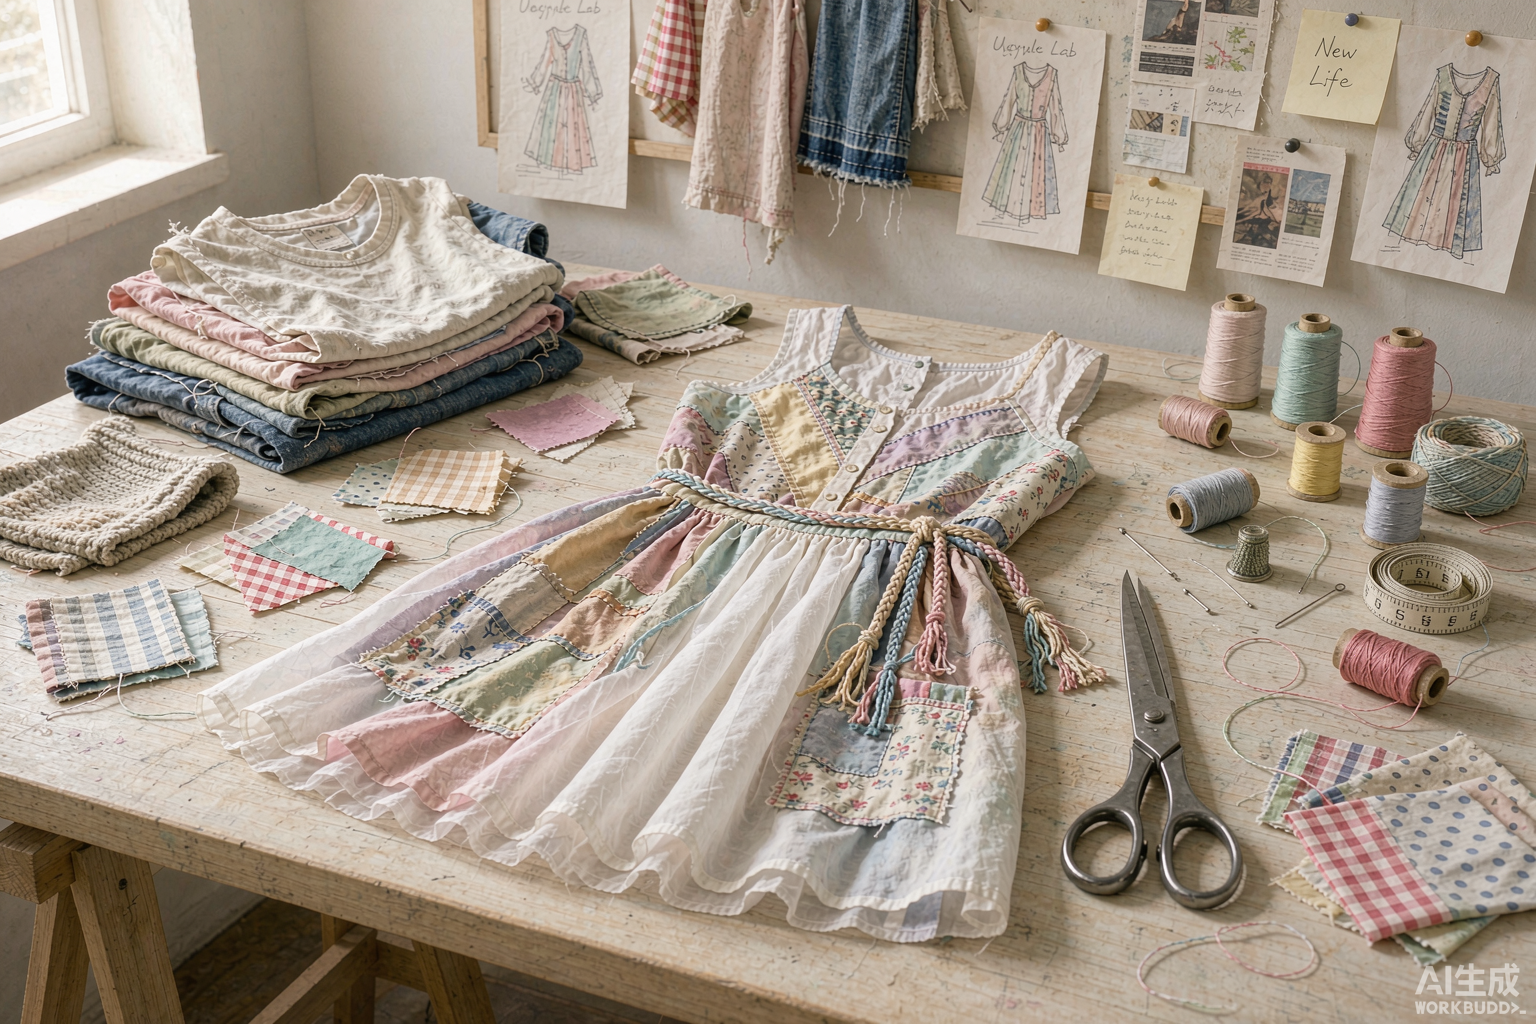
    快时尚让衣柜膨胀,也让衣物寿命缩短。旧衣改造(Upcycling)是一种逆流而上的选择:不丢弃、不将就,用创意和手工让旧衣服变成独一无二的时尚单品。

    改造思路一:尺寸重塑

    买大了的T恤可以改成oversize背心或购物袋;紧身裤可以剪成骑行短裤;长款衬衫可以收腰变成连衣裙。一把剪刀、一台缝纫机,就能让不合身的衣服重新合体。

    改造思路二:拼接混搭

    两件旧牛仔衣可以拼接成一件不对称夹克;不同花色的衬衫袖子互换,创造撞色效果;旧毛衣剪下图案部分缝在新卫衣上,变成个性徽章。拼接的精髓在于「意外组合」产生的视觉张力。

    改造思路三:染色焕新

    泛白的牛仔裤用靛蓝染料重新上色; stained的白T恤用扎染技法赋予新图案;旧帆布包用植物染料染成大地色系。染色是最直接的「换肤」方式,能让一件旧衣焕然一新。

    改造思路四:功能转换

    旧牛仔裤的裤腿可以做成笔袋或工具包;破损的毛衣可以剪开做成抱枕套;不再穿的衬衫可以改造成围裙。功能转换的核心是跳出「衣服只能穿」的思维定式。

    改造思路五:装饰升级

    刺绣、贴布、珠片、铆钉——这些装饰手法能让基础款变成限量款。在牛仔外套后背绣一幅小画,在帆布包上缝一串流苏,在旧帽子上别几枚 vintage 胸针。装饰是最低成本的个性化。

    旧衣改造的乐趣在于「不可复制」。每一件改造后的衣服都承载着主人的审美和故事,这是快时尚永远无法提供的价值。

  • 正念冥想实践:在喧嚣中找到内心的安静角落

    正念冥想实践:在喧嚣中找到内心的安静角落

    我们的注意力正在被切碎。一条推送、一个弹窗、一段短视频,都在争夺大脑有限的认知资源。正念冥想(Mindfulness)提供了一种反制方案:不是逃避喧嚣,而是在喧嚣中训练专注。

    正念是什么

    正念源自佛教禅修,但在当代已经去宗教化,成为一种 secular 的心理训练技术。其核心定义是「有意识地、不评判地关注当下」。不是清空思绪,而是观察思绪的来去;不是追求特殊体验,而是如实觉察此刻的身体感受、情绪和念头。

    科学验证的效果

    过去四十年,正念被广泛应用于临床医学和心理学研究。证据显示,持续的正念练习可以:降低皮质醇水平(减压)、改善前额叶皮层功能(提升专注力)、调节杏仁核反应(减少焦虑)、增强海马体灰质密度(改善记忆)。正念减压疗法(MBSR)和正念认知疗法(MBCT)已被纳入多国医疗指南。

    入门练习:呼吸觉察

    最简单的正念练习是「呼吸觉察」:

    1. 找一个安静的地方坐下,脊柱自然挺直,双手放在膝盖上
    2. 轻轻闭上眼睛,将注意力放在鼻孔附近,感受呼吸时气流的进出
    3. 当注意力被思绪带走时,不要责备自己,温和地将注意力带回呼吸
    4. 从每天5分钟开始,逐渐延长到15-20分钟

    日常正念:不止于坐垫

    正念不只发生在静坐时。走路时觉察脚底与地面的接触,吃饭时觉察食物的味道和质地,洗碗时觉察水流过手指的温度——这些「微型正念」时刻,比长时间的静坐更容易坚持。

    常见误区

    「我必须停止思考」是新手最常见的误解。试图停止思考本身就是一种执着。正念的态度是:念头来了,看见它,不追随,也不驱赶,让它自然消散。

    正念不是让你变成另一个人,而是让你更清晰地看见自己本来的样子。在这个意义上,它是一种回归,而不是一种获得。

  • WebGPU 时代:浏览器里跑大模型

    WebGPU 时代:浏览器里跑大模型

    过去十年,浏览器是「看」网页的工具;2024 年之后,它正在变成「算」网页的容器。WebGPU 标准的全面落地,让浏览器第一次可以直接调用本地显卡,速度比 WebGL 快一个数量级——这一次,受益最深的是 AI 大模型。

    WebGPU 解决了什么

    以前的 WebGL 是为 3D 图形设计的,它能跑大模型但路径非常别扭。WebGPU 重新设计了三层核心:计算着色器(compute shader)、现代 GPU 内存模型、低开销指令提交。这些特性恰好是大模型推理最需要的底层能力。

    实测下来,同样一颗 M2 芯片,在 WebGPU 上跑 7B 参数模型的速度比 WebGL 快 5-10 倍,某些操作甚至能接近原生框架。

    「在浏览器里跑大模型」意味着什么

    第一,零安装。打开网页就是入口,没有下载 Docker、没有 Python 环境、没有驱动兼容问题。隐私敏感的数据不会离开本机——这在医疗、法律、教育等场景格外重要。

    第二,跨平台。一次开发,Windows、macOS、Linux、Android 都能跑(iOS Safari 仍在跟进)。对企业来说,前端同学可以做过去只有客户端工程师才能做的事。

    第三,可组合。WebGPU + WebAssembly + IndexedDB,让开发者可以做出同时具备本地推理、本地存储、本地工具调用的完整 AI 应用,而这一切都在浏览器里。

    现实难点

    WebGPU 并非银弹。第一,模型大小仍受限于设备内存——普通笔记本 16GB 显存是上限,要跑 70B 仍需云端。第二,浏览器厂商的实现仍有差异,Chrome、Edge、Firefox 之间的兼容性需要工程化适配。第三,电量与散热,移动设备跑 7B 模型依然吃力。

    已经能做什么

    今天的浏览器里已经有几十个 demo:本地运行的 LLM 聊天、写代码助手、图像生成、语音转录。主流开源模型(Llama、Mistral、Phi、Qwen)的 GGUF/ONNX 版本大多有现成的 WebGPU 加载方案。

    对于个人开发者,这意味着做 AI demo 的门槛从未如此之低;对于企业,这意味着把 AI 嵌入 SaaS 产品的路径被打开——在不依赖云服务的情况下,前端就能交付真正可用的智能功能。

    下一步:前端工程师怎么准备

    不需要理解 GPU 编程的所有细节,但需要熟悉三个新工具:Transformers.js、ONNX Runtime Web、web-llm。这三个库已经把绝大多数大模型推理封装成「下载即用」的 JavaScript 接口。

    WebGPU 不会取代云端 GPU 集群,但它会重新定义「轻 AI」的边界——以后轻量任务先在浏览器解决,重任务再回云端,会成为最自然的分层架构。

    WebGPU 时代封面
  • AI 视频工作流:从脚本到成片的全链路

    AI 视频工作流:从脚本到成片的全链路

    过去两年最显眼的 AI 突破不在文本,而是在视频。从脚本、镜头、配音到成片,今天已经可以由一串 AI 工具串联完成。本文梳理一条适合个人创作者和小工作室的「AI 视频工作流」,并提示每一环最常见的坑。

    第一环:脚本

    GPT-4、Claude、Gemini 等大模型写脚本已经非常成熟,但真正决定成片质量的是「视觉化脚本」——每 5 秒一个镜头,每个镜头注明画面内容、字幕、运镜、转场。

    提示词模板:「按 30 秒短视频结构,写一份 5 镜头的脚本。每个镜头给出画面描述、台词、字幕、BGM 节点。」

    第二环:分镜与画面

    有了视觉化脚本,画面生成有两种路径:

    第一种是「图生视频」——先用 Midjourney、Flux、即梦生成关键帧静态图,再用可灵、Runway、Pika 等图生视频模型让画面动起来。这种方式可控性高、风格一致性好,是大多数高质量创作者的选择。

    第二种是「文生视频」——直接用 Sora、可灵、PixVerse 等模型从提示词生成整段视频。速度更快但可控性差,适合「氛围镜头」而非「情节镜头」。

    第三环:配音与字幕

    配音推荐使用 AI 声音克隆——11 Labs、字节豆包、阿里 CosyVoice 的中文模型已经达到以假乱真的水平。关键是先用 Whisper 等工具把脚本转成带时间轴的字幕,再让配音模型按时间轴生成语音,做到音画严格对齐。

    字幕不要再硬编码进画面,而是单独输出 SRT 文件,后期合成时方便调整。

    第四环:剪辑与合成

    AI 视频片段经常出现镜头闪烁、动作不连贯的情况,剪辑端的工作比想象中重。建议三个细节:

    第一,每段素材前后留 0.5 秒的「呼吸帧」,避免硬切。第二,统一调色(用 DaVinci Resolve 的 AI 一键调色),否则多源素材颜色割裂。第三,关键节点加转场音效(BGM 转场点)来掩盖画面跳点。

    第五环:审核与迭代

    把成片送两个人看:一个是「目标观众」,获取反馈;一个是「细节强迫症」,专门盯着画面瑕疵看。把反馈整合进下一版工作流,才会让作品越做越稳。

    常见误区

    误区一:以为 AI 能「一键成片」。它能,但产物难以商用。专业可用的视频仍然需要精修。

    误区二:忽视版权。图生视频的源图若是 Midjourney 风格、商业模型版权敏感区,需要额外授权。商用项目尽量用自训练 LoRA 或开源素材。

    误区三:把 AI 当万能解。AI 视频目前仍无法替代真人出镜的真实感与人情味;它最适合做的是「可视化道具」,而不是「主角」。

    一条可上手的最小工作流

    GPT 写脚本 → Flux 生图 → Runway 图生视频 → 11 Labs 配音 → DaVinci Resolve 剪辑 + 一键调色 → CapCut 自动加字幕。一台 4070Ti + 一个有耐心的人,一周可以稳定产出 3 条 60 秒以内的成片。

    AI 视频真正的护城河不是工具,而是「会改稿的人」。

    AI 视频工作流封面
  • NeRF 与高斯泼溅:从照片到可探索的三维世界

    NeRF 与高斯泼溅:从照片到可探索的三维世界

    过去你想把一段真实空间搬到屏幕上,需要昂贵的激光扫描或者专业的建模团队;2025 年之后,你只需要一台手机或单反,围着空间拍 50-200 张照片,就能在本地 GPU 上重建出一个可以走进走出的三维世界。这场变革的两大核心技术——NeRF 和 3D Gaussian Splatting,正在重新定义「三维内容」的生产门槛。

    NeRF:从隐式函数到可微渲染

    NeRF(Neural Radiance Fields)把三维场景编码为一个神经网络,输入是空间坐标与视角方向,输出是该点的颜色与密度。训练时通过大量已知视角的照片反向优化网络参数,推理时则可以从任意新视角合成图像。

    它的优势是输出质量极高,照片级真实感强;缺点是训练慢、推理慢、对显存要求高。一张 1080p 渲染通常要数秒,对实时交互并不友好。

    3D Gaussian Splatting:把场景变成一堆彩色雾

    2023 年提出的 3D Gaussian Splatting(3DGS)用了一组完全不同的语言。它把场景表示为上百万个「高斯椭球」——每个椭球有自己的位置、形状、颜色、透明度。渲染时把这些椭球投影到屏幕上再按 alpha 混合。

    这一表示的优势非常明显:训练快(几十分钟而非几小时)、渲染快(实时 30 fps 以上)、编辑性好(你可以单独移开某个椭球,也就是移走场景中的一个物体)。它迅速成为文化遗产建模、游戏资产生成、虚拟制片的首选方案。

    两种路线的对比与互补

    NeRF 像油画——每一笔都是神经网络内部参数;Gaussian Splatting 像水彩——每个色块都是独立的实体。二者在质量、速度、可编辑性上有截然不同的权衡。

    实践中越来越常见的方案是混合使用:高斯泼溅做主体几何与快速预览,NeRF 做局部精细重建;或者把高斯泼溅当作中间产物,提取网格后做下游加工。

    工具链已经平民化

    今天你能找到的开源工具包括:Nerfstudio(Meta,学术研究首选)、gsplat(轻量、Python 友好)、Polycam(手机 App)、PostShot(桌面端、消费级 GPU 可跑)。

    硬件门槛也在快速下降——RTX 3060 以上即可完成大多数场景的训练;Mac M2 芯片可以用 MPS 加速完成中小场景。

    它会改变什么

    短期来看,电商、家装、文博、影视预览等场景首先受益:商品空间展示、装修预演、文物数字化、虚拟片场都将不再依赖专门团队。

    长期来看,这是「空间互联网」的起点。当任意真实空间都可以被几小时的拍摄变成可探索的三维资产,整个虚拟世界与物理世界的边界都会开始模糊。

    高斯泼溅不会取代传统建模——但它正在让「拍照建三维」成为人人可用的工具。

    NeRF 与高斯泼溅封面
  • 盐系料理:少即是多的家庭烹饪哲学

    盐系料理:少即是多的家庭烹饪哲学

    盐系料理封面

    盐系料理不是指“很咸”,而是强调用盐引出食材本味、避免过度调味的烹饪哲学。它源自日本家庭厨房,核心信念是:好的食材只需要最少的加工。

    选择盐是第一步。粗盐适合腌制和烧烤,海盐适合最后点缀,岩盐则适合煎肉时均匀受热。不同的盐在口腔中释放的速度不同,会直接影响风味层次。

    三道入门级盐系思路:盐烤鱼,用厨房纸吸干水分后两面撒盐,放进烤箱或平底锅,让鱼表面形成焦脆层;出汁煮菜,用昆布柴鱼高汤加少许盐煮根茎蔬菜,甜味会被放大;盐饭,煮饭前在米中加入一小撮盐,能明显提升米饭的甘甜感。

    盐系料理的终点不是“清淡”,而是让每一种食材都被清楚地尝到。少即是多,在这里是一句可以被舌尖验证的真理。

  • 居家香氛系统:用气味划分生活场景

    居家香氛系统:用气味划分生活场景

    居家香氛封面

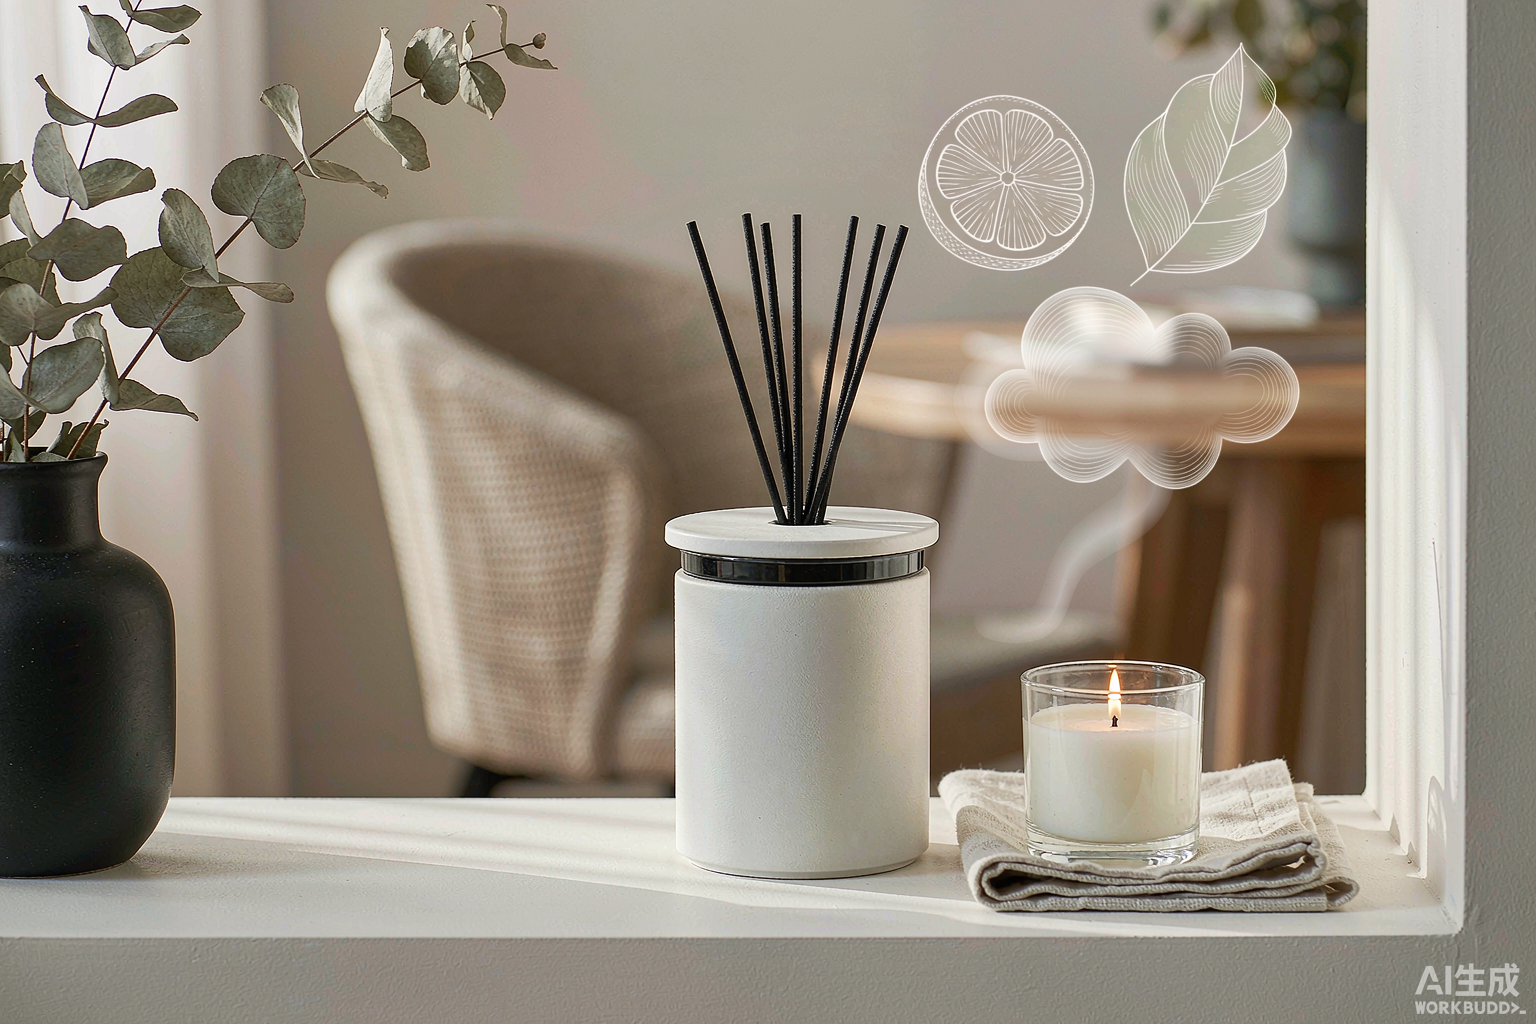
    家不只是视觉空间,也是嗅觉空间。不同的气味能唤醒不同的记忆与情绪:柑橘让人清醒,薰衣草让人放松,雪松让人感到稳定。

    把家按功能划分气味场景是一种实用的做法。玄关用清新柑橘或绿叶香,给人“切换状态”的暗示;客厅用中性木质调,适合会客与休闲;卧室用薰衣草或洋甘菊,帮助入眠;工作区用薄荷或迷迭香,提升专注力。

    香氛工具可以组合使用:无火藤条扩香适合玄关和客厅,香薰蜡烛适合晚餐或泡澡时点,精油喷雾则可以灵活调整局部气味。注意通风,避免长时间高浓度使用。

    找到适合自己的“家的味道”后,每次推开门,就像进入一个只属于你的情绪容器。气味不会说话,却能让空间更温柔。

  • 苔藓微景观:在玻璃罐里造一座山

    苔藓微景观:在玻璃罐里造一座山

    苔藓微景观封面

    苔藓是地球上最古老的植物之一,却最适合被装进玻璃罐里,成为办公桌上的迷你山林。苔藓微景观不需要阳光直射,也不需要频繁浇水,是新手也能轻松驾驭的桌面自然。

    准备材料:一个带盖玻璃罐、火山石或陶粒作为排水层、水苔或赤玉土、新鲜苔藓、几块小石头和一个小摆件。底层先铺排水石,再铺水苔和薄土,最后把苔藓按进去压紧。

    造景的核心是“高低错落”:把石头堆成小山,让苔藓顺着坡面生长,摆件放在视觉焦点上。注意不要把苔藓埋得太深,它只需要贴合基质表面即可。

    养护很简单:保持玻璃罐内湿润,每周喷雾一到两次,避免暴晒。如果罐壁出现大量水珠,稍微开盖通风。几个月后,苔藓会自然舒展,玻璃罐里的山林也会越来越有野趣。

  • 城市漂流图书馆:让书在陌生人之间流动

    城市漂流图书馆:让书在陌生人之间流动

    街头漂流图书馆

    在城市的街角、公交站旁、社区花园里,你也许见过一个木箱,里面装着十几本书,写着「取走一本,留下一本」。这就是漂流图书馆——没有借书证、没有逾期费、没有管理员,全靠信任运转。

    从书架到街头

    漂流图书馆的雏形是2009年美国威斯康星州Todd Bol为纪念母亲而设立的前门书箱。这个举动启发了一个全球运动:Little Free Library,目前在全球超过11万个注册站点,交换了数以千万计的图书。中国版的城市漂流书架出现在2014年前后,由民间阅读推广人自发搭建,散布在社区、咖啡馆和地铁站附近。

    信任经济学

    漂流图书馆的核心不是藏书量,而是信任。它依赖一个简单的规则:取走一本,留下一本。没有强制执行机制,靠的是社区共识和重复博弈——如果你这次只取不留,下次箱子可能就空了或消失了。行为经济学研究显示,在匿名环境下,公共物品博弈的合作率在30%至50%之间,但一旦加入「可见性」——你的行为被社区观察——合作率会显著上升。

    漂流的不是书,是关系

    漂流图书馆最意外的效果是社交。书箱变成了社区的微型公共空间——取书的人会停留几分钟,翻翻别人留下的书,偶尔遇到另一个取书者就聊上几句。在邻里关系越来越淡的城市里,一个木箱把陌生人连接成了围绕阅读的弱关系网络。很多书箱管理者发现,书不是流失最快的资源,而是积累最快的——很多人放的书比取走的多。

    数字漂流与实体漂流

    除了实体书箱,还有基于App的图书漂流——扫描书籍条码标记「漂流中」,然后放在公共场所供人取阅并接力。这种方式扩大了传播半径,但也稀释了社区感。最好的模式是两者结合:实体书箱负责社区粘性,数字平台负责追踪和发现。下次路过一个书箱时,不妨取走一本你喜欢的,留下一本你想分享的——你参与的不只是一次图书交换,而是一条城市里的信任链。